Intelligent UI 怎么用?让 AI 把技术原理变成可操作的小实验
交互式回答怎样帮助理解技术原理?本文只用并发与排队这一个案例,通过三张真实操作截图比较降低流量与提高处理能力的效果,并介绍适用场景、提问方法与不同 Agent 的相近能力。

AI 能把技术解释变成一个可操作的小实验。本文围绕“并发与排队”这一个案例,用三张真实操作截图说明交互式回答的价值、使用方法,以及不同 Agent 的相近能力。
问 AI:“为什么接口会排队?”它可以解释请求到达量、处理耗时和并发能力之间的关系。
再加一句:“做成可交互的小实验,让我调整这三个条件。”答案就可能变成带有滑块、指标和队列的小界面。
它的价值在于:读者先猜结果,再调整条件,用界面的变化验证自己的判断。下面保留一个并发排队案例,介绍适用场景、提问方法,并用三张截图展示实际操作后的结果。
1. 怎样的交互真正帮助理解?
一种设计是点击“下一步”,逐段显示请求进入、等待、处理和完成。这能展示流程,却很难比较不同条件下会发生什么。
更有用的设计,是把请求到达量、单次处理耗时和并发槽位做成三个滑块。调整后立即重算等待队列和预计平均响应时间。
读者可以带着具体问题操作:流量降下来,队列会不会消失?处理更快、槽位更多,能改善多少?
每次操作都应改变一个有意义的条件,并给出可以比较的结果。 比较单个因素时,每次只调整一个变量;调整多个因素时,要说明结果来自它们共同变化。
2. Intelligent UI 在这里指什么?
本文用“交互式回答”描述这种能力:AI 根据问题,生成可以在对话中操作的图表、计算器、模拟器或小工具。
各家产品的正式名称不同,不宜把 Intelligent UI 当作统一的功能名。OpenAI 官方将相关能力称为 Visualizations / Visualize,包含交互解释、图表和模拟等形式。OpenAI 官方说明
可以把它理解为:模型负责组织内容和生成界面,客户端负责展示并执行交互。能生成代码,与当前聊天窗口能否展示交互内容,是两个需要分别确认的问题。
它也适合继续修改。你可以在看完结果后追问:“加入突发流量”“换成我的数据”“比较扩容前后”。讨论会围绕一个能观察的对象展开。
3. 哪些场景值得做成小实验?
最适合的,是包含变量、取舍或状态变化的问题。
理解技术机制。 调整请求量、并发和处理耗时,观察队列。比记住一段定义更有针对性。
比较不同方案。 输入实际预算、调用次数和服务约束,查看成本或结果如何变化。判断依赖哪些假设,应随界面一起说明。
探索已有数据。 按时间或分类筛选,再查看某个数据点。用于分析的数值应来自提供的数据,不能让模型补出看起来合理的记录。
讨论产品流程。 点进页面、提交表单、查看失败状态,用可操作的流程验证设计是否顺畅。
并非所有回答都要做成界面。一句定义、几条步骤、一个静态模块关系,文字或普通图往往已经足够。
判断标准可以很直接:读者动一下,能否发现仅靠阅读不容易看出的关系?
4. 怎样提出一个有效的要求?
只说“做得炫一点”,很容易得到漂亮但信息有限的界面。
更有效的要求包含四项:想理解的问题、可以修改的条件、需要观察的结果,以及模型的适用边界。
下面这段可以直接复用:
用一个交互模拟解释接口排队。让我调整请求到达量、单次处理耗时和并发槽位,立即显示十秒后的等待队列与本批请求的预计平均响应时间。初始参数是每秒九十五次请求、单次四百五十毫秒、四个并发槽位。说明模拟假设,不需要逐步点击。
生成后,先检查三件事:输入变化后是否真的重算,单位是否正确,极端条件下是否符合基本逻辑。
例如,把请求量降得很低,队列应消失;在耗时不变的理想模型里增加独立处理槽位,处理上限应提高。发现不合理的结果,直接指出现象,让 Agent 修正计算逻辑。
在支持的 ChatGPT 客户端,可以输入 @Visualize 并选择对应建议。是否能看到入口,受账号、平台和工作区设置影响;官方文档明确说明,Codex CLI 与 IDE 扩展不支持 Visualizations 渲染。官方使用方法
5. Claude、Gemini 也能做吗?
有相近能力,区别主要在输出位置和后续使用方式。
Claude Custom visuals 可以直接在对话中生成交互图,支持点击按钮、调整滑块,再通过追问修改。官方说明其在网页和桌面端提供,当前属于测试阶段。Claude 官方说明
如果目标是保留、修改和分享一个工具,Claude 还有 Artifacts。Artifacts 官方说明
Gemini Canvas 可以创建、预览并修改应用。选择 Canvas,描述希望实现的功能,生成后继续通过对话调整。Gemini 官方说明
选工具时,先看自己需要什么:是在当前对话里理解一个问题,还是准备保留和分享一个应用。再确认实际客户端能否运行相应交互。
上面的功能信息核对于 2026 年 10 月 10 日;具体入口以账号实际显示为准。
6. 一个案例,三张截图:并发与排队
下面三张图来自本次交互实验的真实操作截图。截图上方还保留了聊天中的其他文字,本文按实验面板实际显示的参数和结果讲解。
这个模型只保留三个变量:请求每秒到达多少次、一个请求需要处理多久、同时能处理多少个请求。它假设均匀到达、固定处理耗时、先进先出、空队列起步,各槽位独立工作,不考虑资源争抢、拒绝、超时和重试。
在这些条件下,理想处理上限可以这样估算:
每秒处理上限 = 并发槽位数 ÷ 单次处理耗时(秒)
第一张:流量远高于处理能力,队列持续积压。
请求到达量为 95 次/秒,单次处理 450 ms,并发槽位 4 个。理想处理上限约为 8.9 次/秒,远低于到达量。
第十秒还有 858 个请求等待开始处理,已完成 88 / 950 个;本批预计平均响应为 48,684 ms,约 48.7 秒。
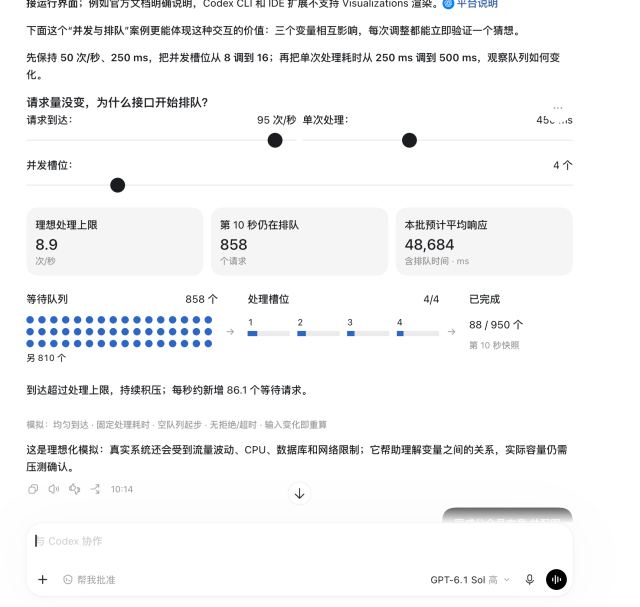
截图 1:95 次/秒、450 ms、4 个槽位;第十秒等待 858 个请求。 查看截图 1 原图
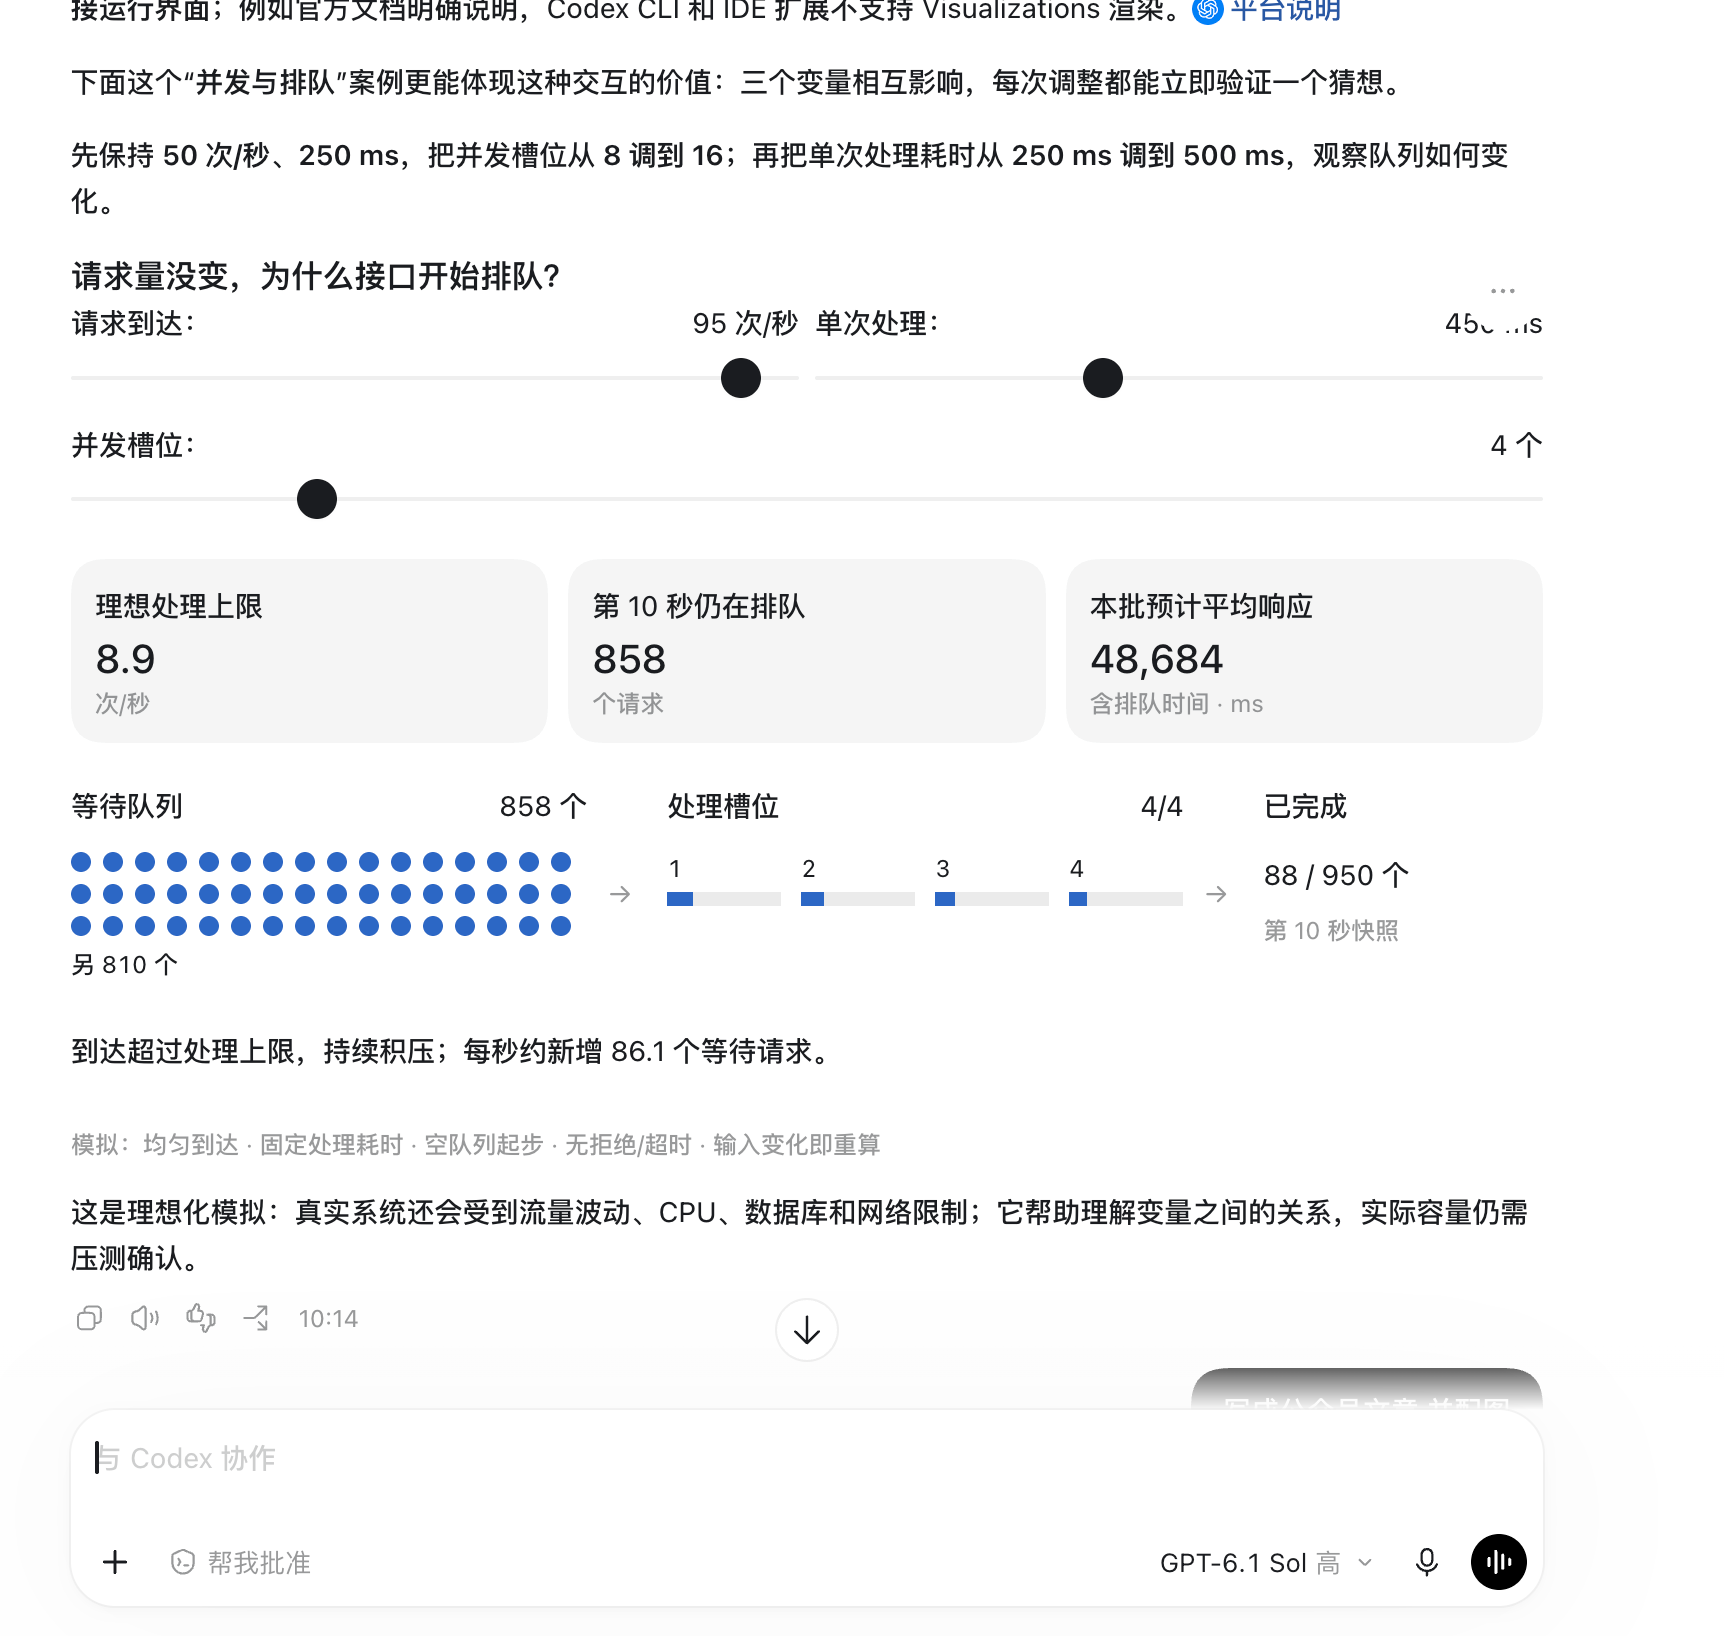
界面把“处理不过来”变成了看得见的队列与数值。在这个理想模型下,每秒约新增 86.1 个等待请求。
第二张:只降低流量,队列变短,但仍然存在。
将请求到达量降到 50 次/秒,保持 450 ms、4 个槽位不变。处理上限仍约为每秒 8.9 次。
第十秒等待数降到 408 个,已完成 88 / 500 个;预计平均响应降到 23,390 ms,约 23.4 秒。
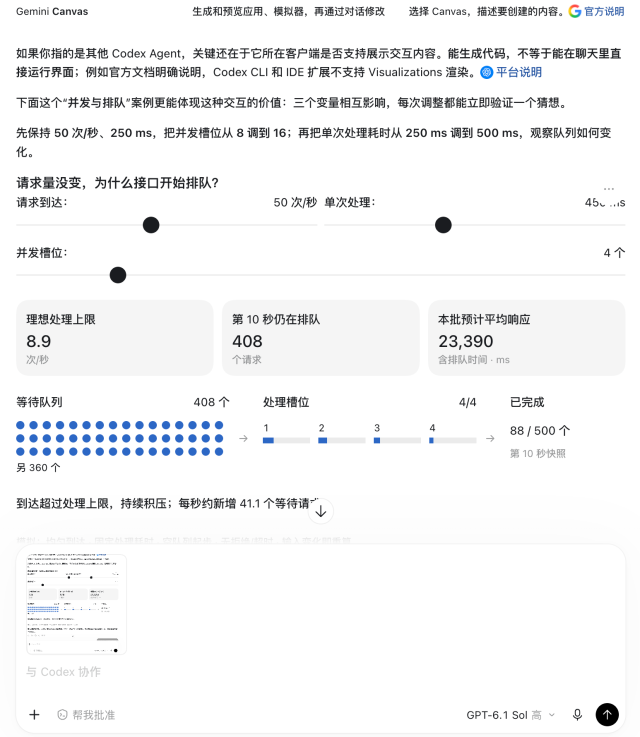
截图 2:只将到达量从 95 降到 50 次/秒,等待数从 858 降到 408。 查看截图 2 原图
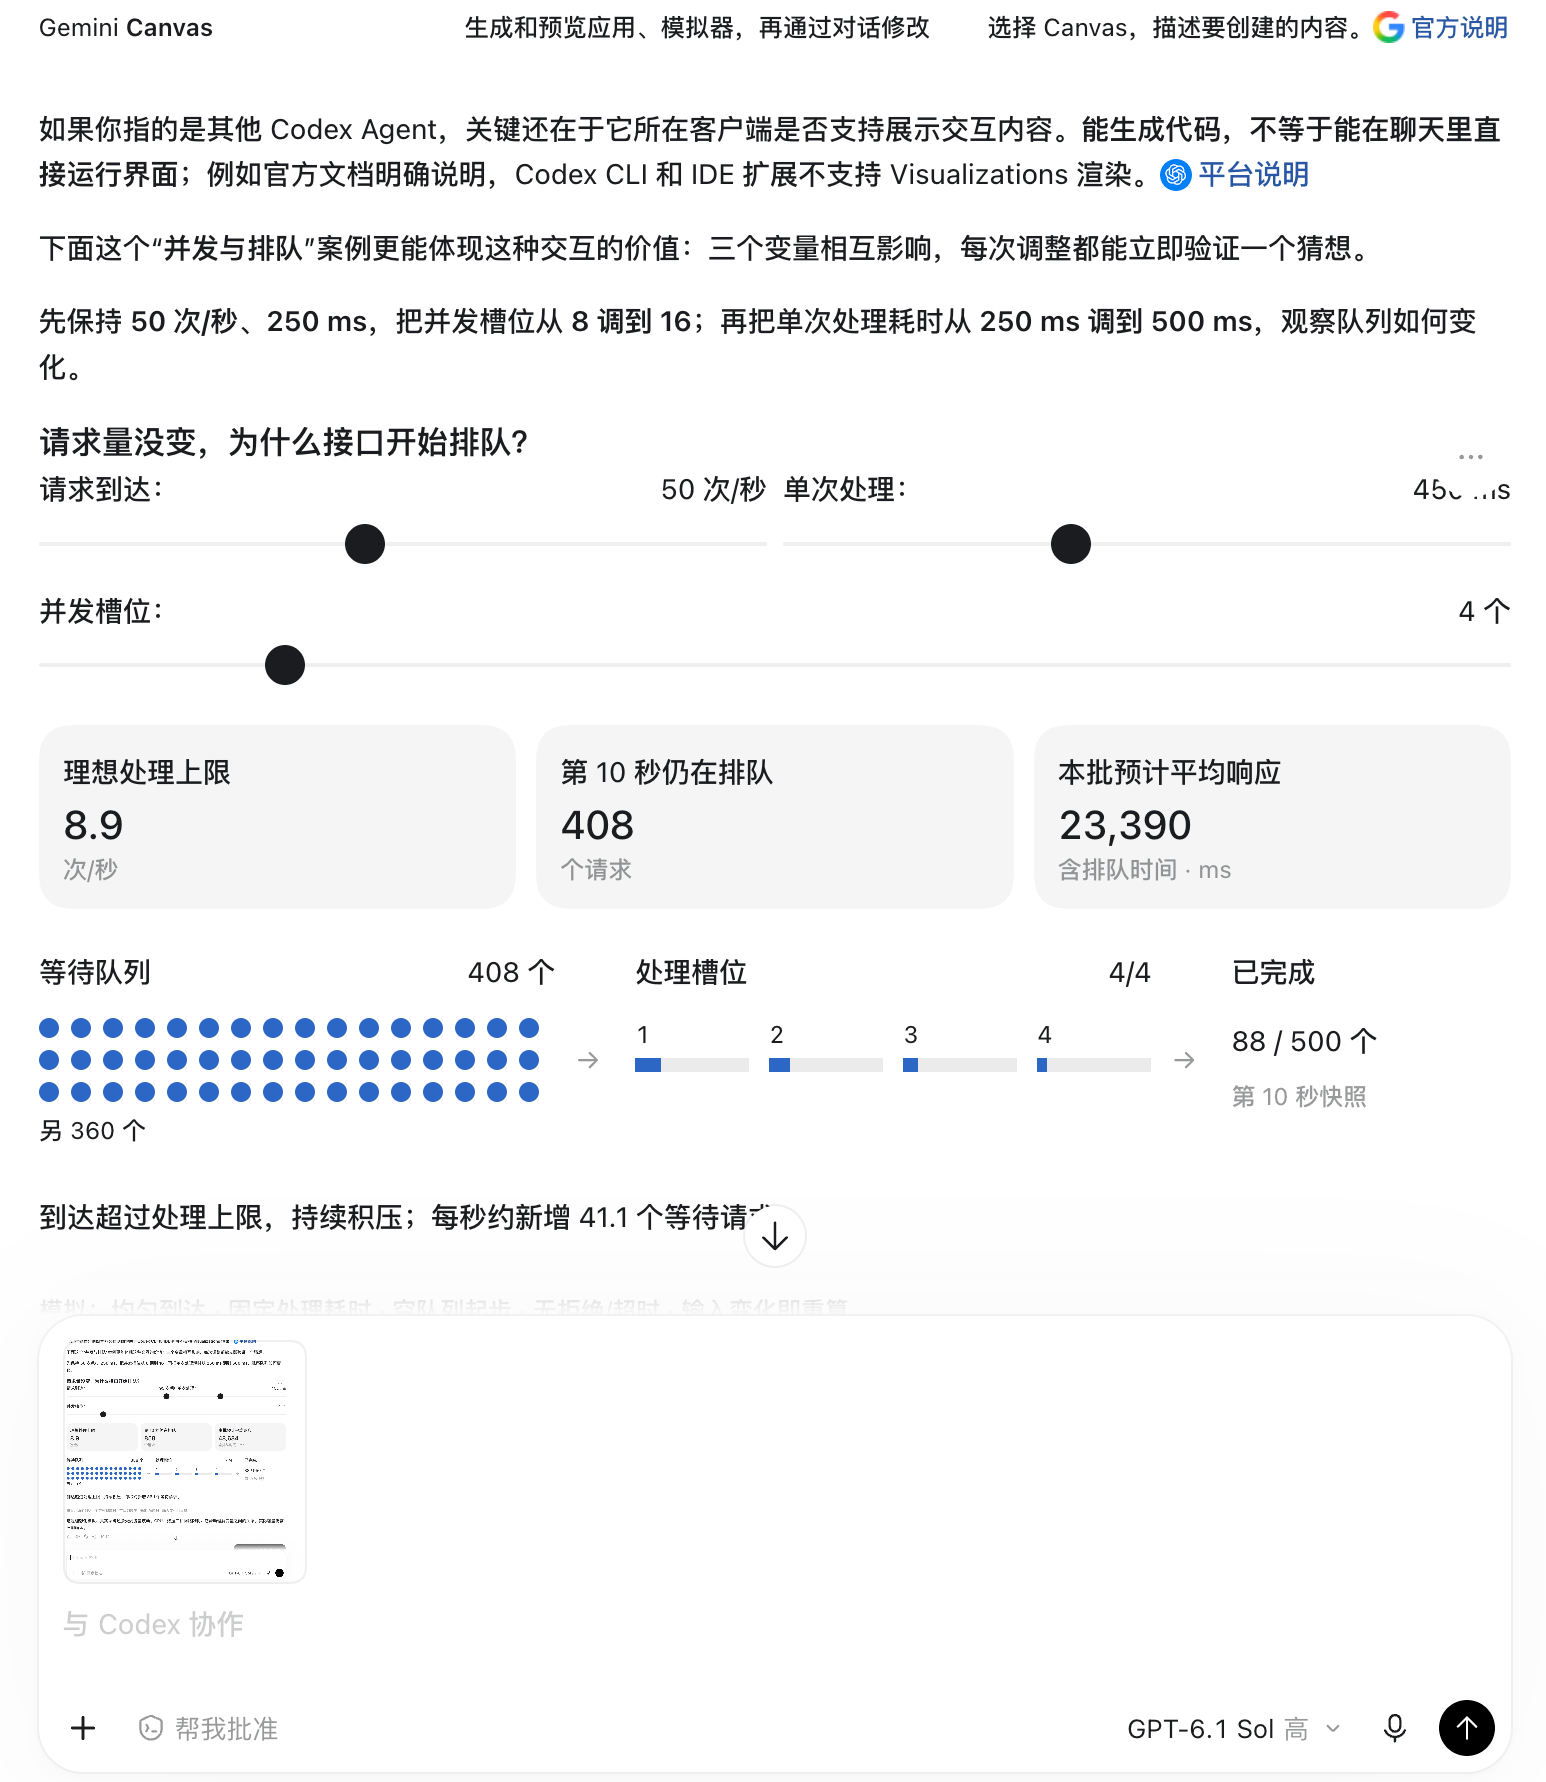
这一步验证了一个边界:降低流量能够缓解积压,但只有降到处理能力可以承接的范围,均匀到达模型才会不再排队。 此时每秒 50 次仍高于每秒 8.9 次,所以队列没有消失。
第三张:提高处理能力,继续观察改善幅度。
保持 50 次/秒,将单次处理耗时降到 300 ms,并发槽位增到 7 个。处理上限提高到约 23.3 次/秒。
第十秒等待数进一步降到 263 个,已完成 230 / 500 个;预计平均响应降到 5,935 ms,约 5.9 秒。
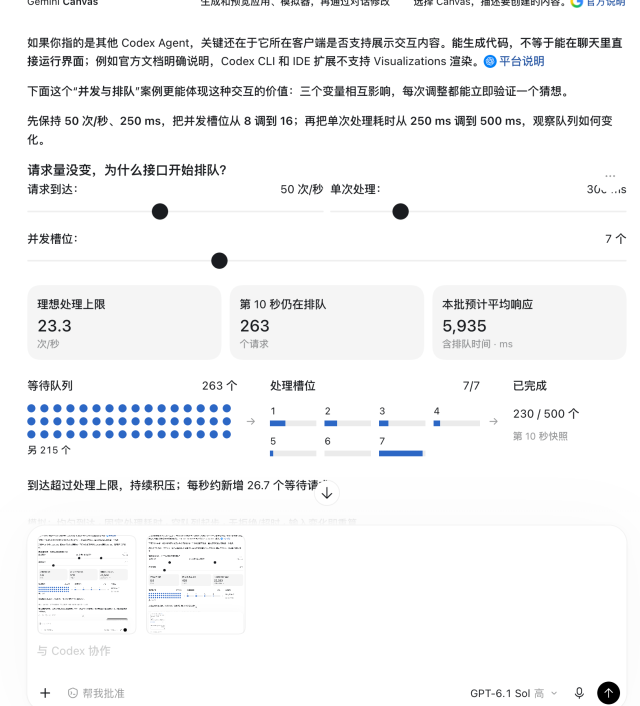
截图 3:50 次/秒、300 ms、7 个槽位;等待数降到 263,预计平均响应约 5.9 秒。 查看截图 3 原图
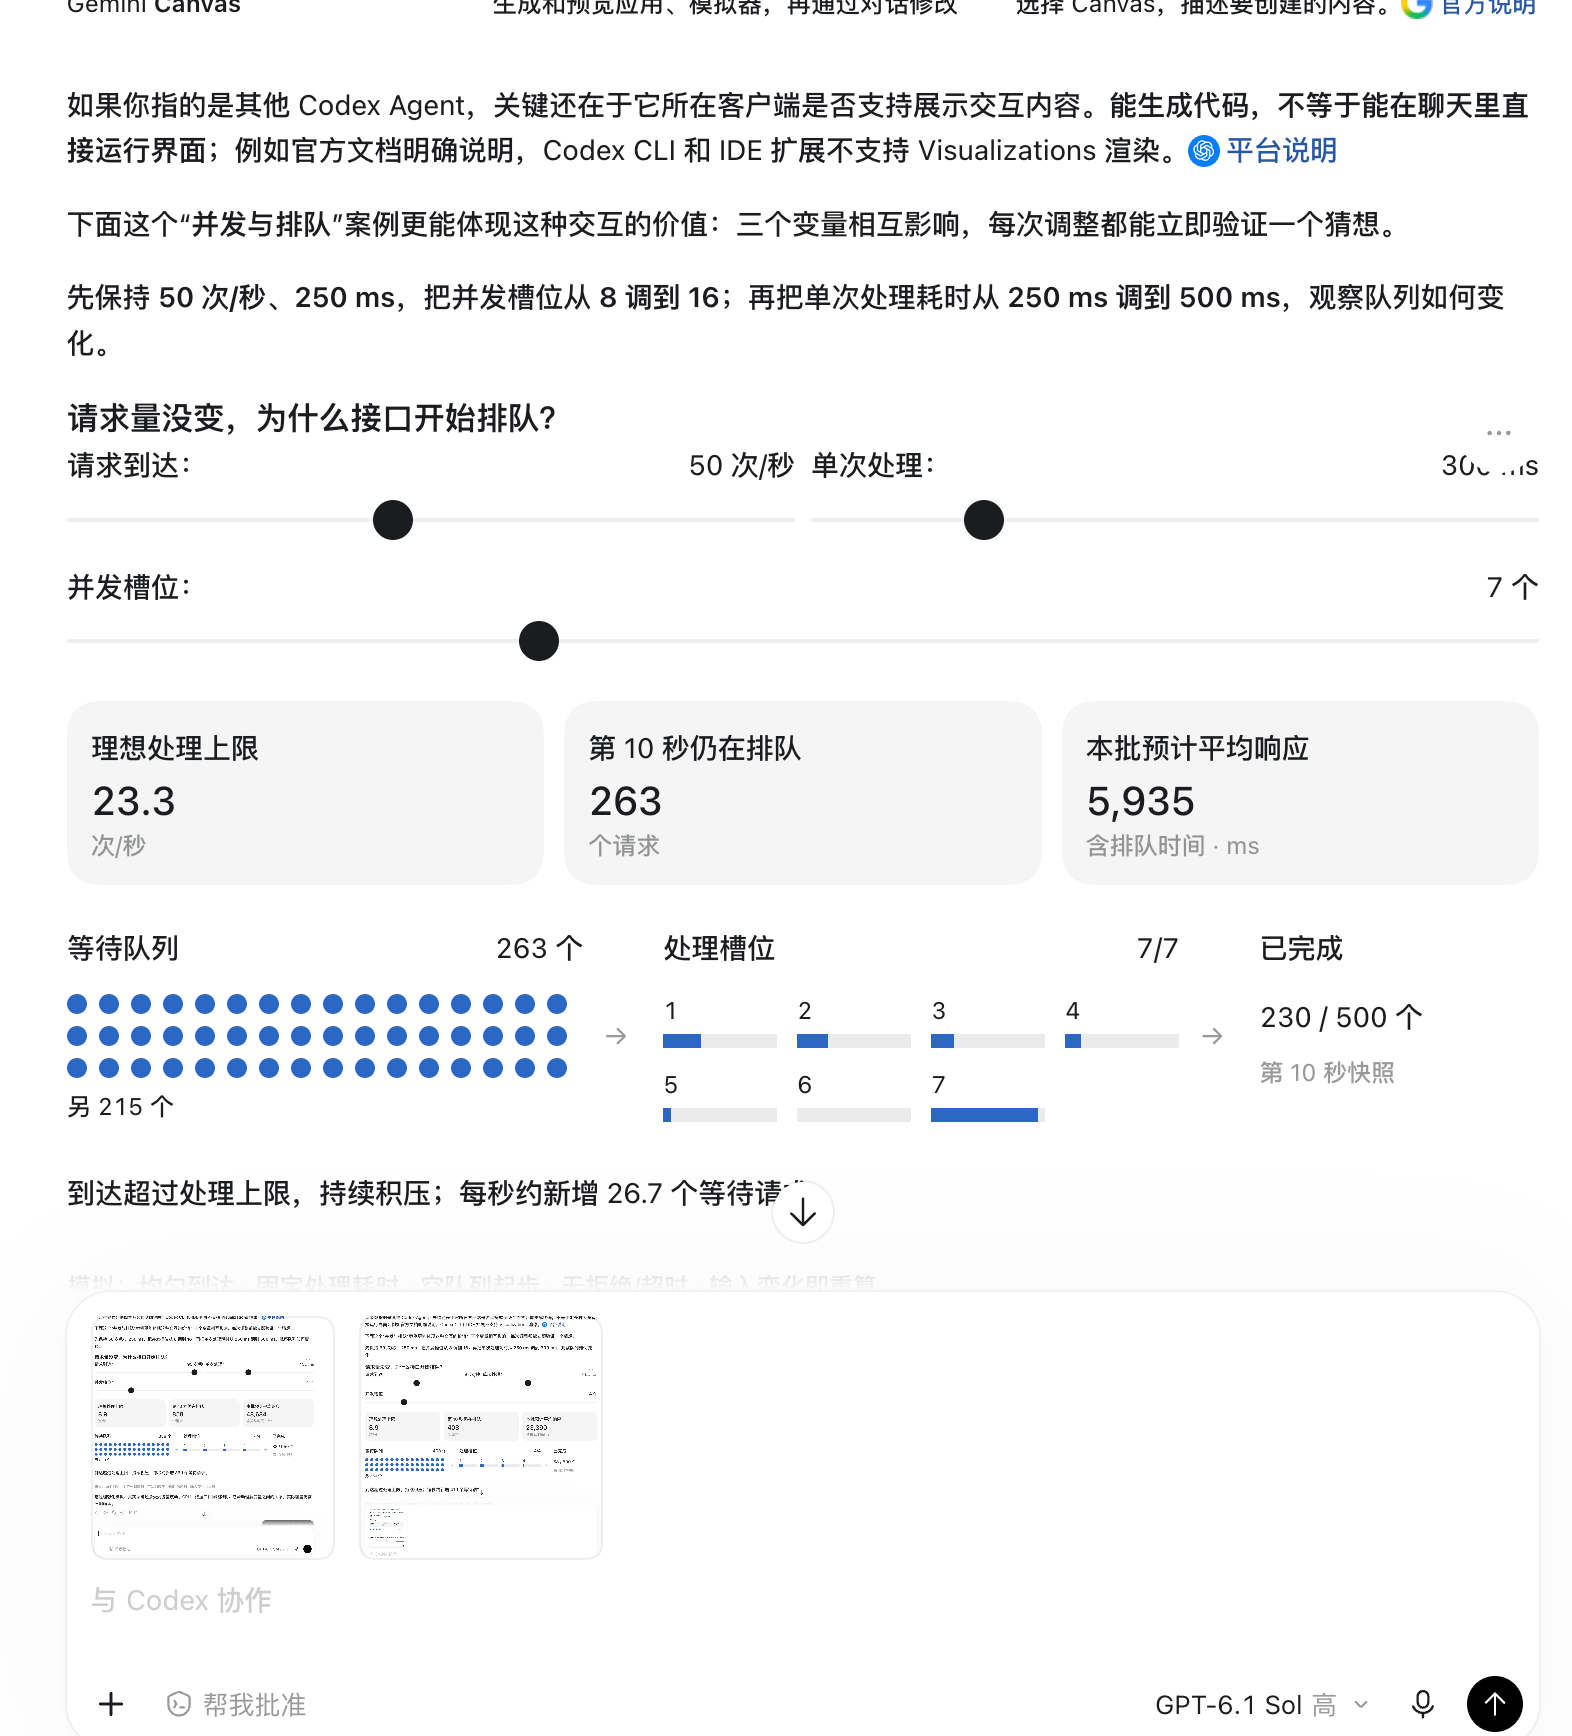
这一张同时改变了处理耗时和并发槽位,展示的是两项调整的共同效果。若想区分各自贡献,可以先只降低耗时,记录结果,再增加槽位进行比较。
改善已经很明显,但到达量仍高于处理上限,因此第三张图仍有排队。看到响应变快,还要继续检查队列是否依然积压。
三张截图中的“第十秒仍在排队”统计尚未开始处理的请求,不包含正在处理的请求。“本批预计平均响应”按这一批请求最终完成的时间计算,包含十秒之后的等待和处理时间,因此可以超过十秒。
每秒 95 次时,十秒内到达 950 个请求;每秒 50 次时,到达 500 个。截图中的结果已按同一离散事件模型复算一致,它们是模拟结果,不是线上性能测量。
真实系统还需要考虑流量波动、CPU、数据库、网络和锁竞争。增加线程或连接数,可能加重资源争抢。这个实验帮助理解变量之间的关系,实际容量仍要通过监控和压测确认。
7. 让读者能够验证自己的猜想
用好交互式回答,可以记住三个动作:选一个存在变量关系的问题,要求明确的输入与输出,再用边界条件检查结果。
界面的目标是让读者看见条件变化带来的影响。即使只有三个滑块,只要计算可靠、结果清晰,也能帮助读者理解一个技术问题。
下一次向 AI 提问,可以把“解释一下”改成:“让我亲手改变条件,看看会发生什么。”
本文用三张真实截图记录同一个排队实验的变化。读者也可以复制提示词,在支持交互的 Agent 中复现,再调整自己的参数。
感谢你读到这里。如果你喜欢这样的技术内容,欢迎扫码关注「Begin Code」,期待与你一起持续学习、共同进步。